cabinet de recrutement et chasseurs de tête de site reliability engineers
votre prochain site reliability engineer, entre de bonnes mains.
Nous combinons nos données, nos experts sectoriels et nos algorithmes d'IA pour identifier le chasseur de tête le plus pertinent pour votre poste, du premier SRE qui pose les SLO d'une plateforme au profil qui encadre l'astreinte d'un éditeur à fort trafic.
- zéro frais de démarrage, paiement à l'embauche
- remplacement garanti
ils recrutent leurs profils infrastructure avec muzzo
comment recruter un site reliability engineer avec un cabinet de recrutement ?
Un SRE se juge à la fiabilité qu'il tient dans la durée : SLO respectés, astreinte gérée, post-mortems qui corrigent vraiment la cause. Muzzo confie votre poste aux chasseurs de tête qui recrutent le plus en fiabilité de production. Commission de 5 à 30 %, payée à l'embauche. Départ sous 3 mois : recherche relancée sans frais.
comment ça marche
vous ne payez que si vous recrutez
01
vous décrivez le poste
Avec le formulaire plus haut : le poste, votre entreprise, votre niveau de trafic. Le reste se cadre au premier échange avec l'équipe Muzzo.
02
nos données choisissent les chasseurs
L'IA retient ceux qui ont le plus recruté de SRE, parmi plus de 2 500 chasseurs de tête sélectionnés.
03
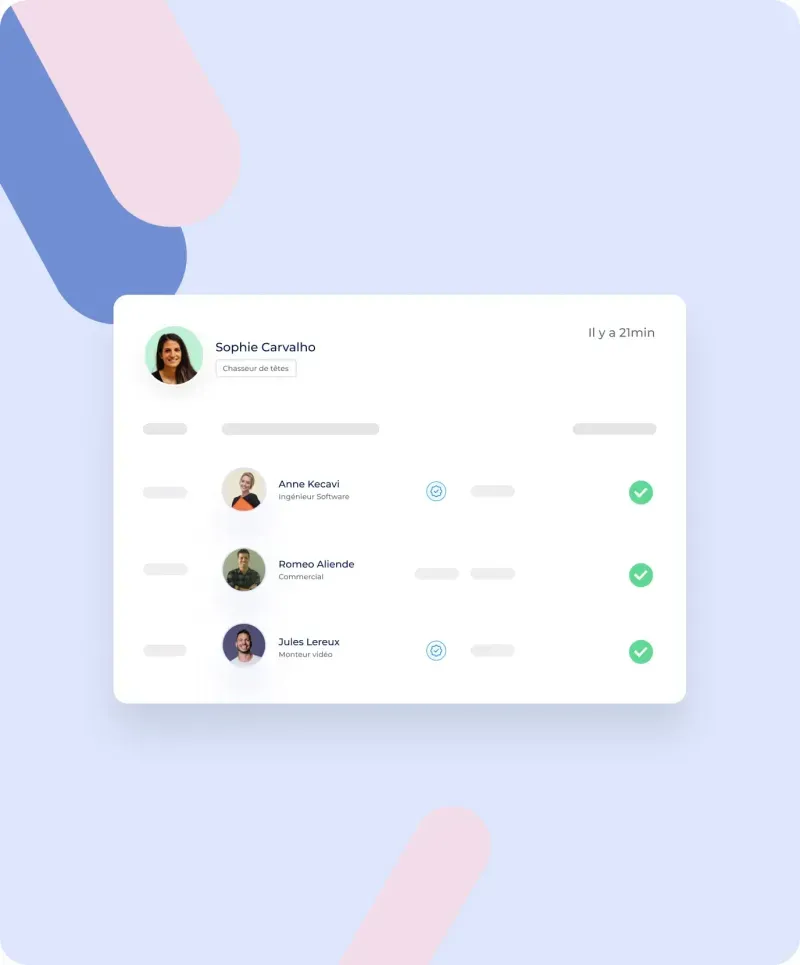
vous rencontrez les meilleurs profils
Approchés et qualifiés par des chasseurs experts de la fiabilité de production. Vous choisissez qui vous voyez.
04
vous recrutez, puis vous payez
Pas avant. Si la recrue quitte son poste dans les 3 mois, on relance la recherche sans frais.
ils ont recruté avec muzzo
L'atout de Muzzo, c'est la diversité des recruteurs : il y a toujours quelqu'un à l'écoute de nos besoins.
Avec Muzzo, j'ai la réactivité d'une marketplace et la qualité d'un cabinet de recrutement.
votre recrutement, discutons-en de vive voix
Antoine et l'équipe Muzzo vous aident à cadrer votre poste et à choisir les bons chasseurs de tête. Décrivez votre poste dans le formulaire : on vous rappelle pour en parler.
Antoine GigomasCEO et cofondateur de Muzzo
une dernière question ?
Avec Muzzo, vous fixez la commission, entre 5 et 30 %, et vous ne la payez qu'à l'embauche : pas d'acompte, pas de frais fixes. Un SRE junior qui rejoint une équipe d'astreinte déjà en place et un lead SRE qui fixe les SLO d'une plateforme à fort trafic ne demandent pas la même recherche. La commission suit cette difficulté, et l'équipe Muzzo vous aide à la fixer.
Vous avez une double garantie. Si la recrue part dans les 3 mois, par exemple parce que l'astreinte réelle ne correspond pas au brief, nous relançons la recherche sans frais. Sans remplaçant trouvé sous 4 mois, nous vous remboursons 50 % des honoraires. En moyenne, 94 % des recrues Muzzo sont encore en poste après 3 mois.
les chasseurs de tête de la fiabilité de production sont prêts à démarrer
Un recrutement signé en moins de 26 jours, payé seulement à l'embauche.
le constat
un site reliability engineer se juge à l'incident qui ne se reproduit pas
un bon SRE est d'astreinte, pas en recherche
Il surveille des SLO, participe à une rotation d'astreinte et n'a aucune raison de répondre à une offre générique. Un chasseur de tête de la fiabilité sait quand et comment l'approcher.
automatiser un déploiement n'est pas garantir une fiabilité
Le poste demande de définir des objectifs de service, de les mesurer et de les défendre face aux équipes produit qui veulent aller plus vite. Le chasseur teste ce dialogue, pas seulement l'outillage.
une erreur de recrutement se voit au prochain incident majeur
SLO jamais tenus, astreinte qui tourne mal, post-mortem qui ne change rien la fois suivante. Le chasseur vérifie les incidents réellement résolus et les post-mortems écrits avant de vous présenter quelqu'un.
les postes
les profils de fiabilité de production que nos chasseurs vont chercher pour vous
Du premier poste de SRE à l'équipe qui encadre l'astreinte d'une plateforme à fort trafic, chaque recherche part chez un chasseur qui a déjà recruté ce profil.
site reliability engineer
Il définit des SLO, surveille l'observabilité et participe à l'astreinte d'une plateforme en production. Le poste le plus demandé.
SRE senior
Il mène les post-mortems des incidents majeurs et fait évoluer l'architecture pour que la même panne ne se reproduise pas.
SRE orienté observabilité
Il construit les tableaux de bord, les alertes et les traces qui permettent de détecter un incident avant qu'il ne s'aggrave.
lead SRE
Il encadre l'équipe d'astreinte, fixe les SLO avec les équipes produit et devient l'interlocuteur du directeur technique.
SRE chez un éditeur SaaS à fort trafic
Il garantit la disponibilité d'une plateforme utilisée en continu, où chaque minute d'incident a un coût direct.
la méthode
un chasseur de tête de la fiabilité de production, pas un généraliste de l'infrastructure
Un SRE se juge à ce qui ne retombe pas en panne. La méthode part donc de ce que la plateforme doit tenir.
on définit les SLO et l'astreinte réels du poste
Niveau de trafic, objectifs de disponibilité, fréquence et partage de l'astreinte : le brief décrit ce que le poste doit vraiment tenir, pas une fiche de poste générique.
un chasseur qui recrute des SRE
Parmi plus de 2 500 chasseurs de tête sélectionnés, votre poste part chez ceux qui recrutent le plus en fiabilité de production.
un incident et un post-mortem vérifiés avant l'entretien
Le chasseur demande au profil de raconter un incident majeur qu'il a géré : sa détection, sa résolution, ce que le post-mortem a changé ensuite. Puis il recoupe en référence.
les chiffres
le salaire d'un site reliability engineer en chiffres
source : Apec, les rémunérations des cadres du secteur privé dans 111 familles de métiers, édition 2025, p. 60 (infrastructures et systèmes informatiques) (ouvre une nouvelle fenêtre), données 2025
source : Apec, les rémunérations des cadres du secteur privé dans 111 familles de métiers, édition 2025, p. 60 (infrastructures et systèmes informatiques) (ouvre une nouvelle fenêtre), données 2025
source : Apec, les rémunérations des cadres du secteur privé dans 111 familles de métiers, édition 2025, p. 60 (infrastructures et systèmes informatiques) (ouvre une nouvelle fenêtre), données 2025
recruter un site reliability engineer : ce qu'il faut savoir
pourquoi confier le recrutement d'un site reliability engineer à un chasseur de tête ?
Le SRE transforme la disponibilité d'une plateforme en objectif mesurable : il définit des SLO, construit l'observabilité qui permet de détecter un problème avant les utilisateurs, et tient l'astreinte quand l'incident arrive quand même. Les bons profils sont en poste, pris par la production, et ne répondent pas aux annonces.
Un chasseur de tête de la fiabilité sait les approcher et poser les bonnes questions : quel trafic, quels SLO, quelle astreinte réelle. Cette page porte sur le poste de SRE lui-même ; pour l'ensemble des métiers d'infrastructure, cloud et sécurité, voyez notre page infrastructure, cloud et sécurité.
SRE ou devops engineer : quelle différence pour le recrutement ?
Un devops engineer construit les pipelines de déploiement et l'outillage cloud qui permettent de livrer vite. Un SRE part de l'objectif inverse : garder le service fiable une fois en production, mesurer cette fiabilité avec des SLO, et porter l'astreinte quand elle casse. Dans une petite structure, une seule personne cumule souvent les deux casquettes.
Décidez dans le brief si le poste doit surtout accélérer les déploiements ou surtout garantir la disponibilité : le chasseur ciblera un profil différent selon la réponse.
comment évaluer un site reliability engineer en entretien ?
Le CV liste des outils de monitoring et d'orchestration. L'entretien doit montrer autre chose : la capacité à diagnostiquer un incident sous pression et à écrire un post-mortem qui change réellement l'architecture ensuite.
Un cas pratique court fonctionne bien : un service qui tombe, des métriques à lire, et vingt minutes pour poser un diagnostic. Le chasseur fait ce premier tri avant de vous présenter quelqu'un, et vérifie en référence les incidents et les SLO que le profil dit avoir tenus.
faut-il un SRE avec ou sans astreinte ?
L'astreinte est au cœur du poste dès qu'une plateforme tourne en continu : sans elle, personne ne répond à un incident hors horaires de bureau. Certaines structures organisent une astreinte tournante sur plusieurs profils pour limiter la charge sur une seule personne.
Ce choix se négocie dès le brief : un poste sans astreinte attire plus large, mais déplace la charge de fiabilité ailleurs dans l'équipe. Précisez la fréquence réelle de l'astreinte avant de lancer la recherche.
où recruter un site reliability engineer : quel âge pour quel salaire ?
Selon l'Apec, le salaire d'un profil de la famille infrastructures et systèmes informatiques (qui couvre le SRE) progresse surtout avec l'âge : 47 k€ médian avant 35 ans, 55 k€ entre 35 et 45 ans, 61 k€ après 45 ans. L'écart entre l'Île-de-France (62 k€) et les autres régions (53 k€) reste plus modéré.
Côté volume, l'enquête BMO 2026 de France Travail situe la catégorie large des responsables et cadres de la production et de l'exploitation informatique surtout à Paris et dans le Seine-Aval, suivis de Lille. Elle ne distingue pas le SRE, mais elle montre où la concurrence entre employeurs est la plus forte.
vos questions sur le recrutement d'un site reliability engineer
L'Apec ne publie pas de fourchette propre au SRE, mais à la famille infrastructures et systèmes informatiques qui le couvre : la médiane passe de 47 k€ avant 35 ans à 61 k€ après 45 ans (édition 2025). L'ancienneté pèse plus que la localisation sur ce métier.
Selon l'enquête BMO 2026 de France Travail, 40,9 % des projets de recrutement de la catégorie large des responsables et cadres de la production informatique sont jugés difficiles par les employeurs, contre 43,8 % tous métiers confondus. Elle ne distingue pas le SRE, mais elle donne un ordre de grandeur sur cette famille de métiers.
Si le poste doit surtout définir des objectifs de disponibilité, mesurer la fiabilité et tenir l'astreinte quand un service tombe, c'est un SRE. Si le poste doit surtout accélérer les déploiements et outiller le cloud, c'est plus proche d'un devops engineer. Beaucoup de petites équipes confient les deux rôles à la même personne.
Par un cas réel plutôt que par la liste de ses outils de monitoring. Nos chasseurs demandent au profil de raconter un incident qu'il a géré sous astreinte, le post-mortem qui a suivi et ce qui a changé dans l'architecture, puis vérifient cet incident en référence.